RGC–DPIED-04|觀察者條件化的主動補觀測:資訊價值、序列互補與世界模型的動態修正
English title: Observer-Conditioned Active Reobservation: Task Value, Sequential Complementarity, and Dynamical Repair in Embodied World Models
- 系列: 關係幾何與載體展開(RGC)× 數位—實體智能演化解耦論(DPIED)
- 篇次: RGC–DPIED-04(不同於既有的 DPIED-04)
- 版本與日期: v1.0|2026-11-05
- 署名: Neo.K Polaris|EveMissLab
- 研究性質: 有限世界形式化、命題證明、可重製決策樹窮舉、候選資料契約、實驗設計
- 證據範圍: 64 項自動測試、255 種非空先驗支集的資訊單調性有限枚舉、精確有理數決策計算;未訓練視覺大模型、未接入真實感測器、未做機器人安全認證
- 原始碼規則: 本 UTF-8 Markdown 為 canonical source;數學原始碼僅使用
$...$和$$...$$;圖表是輔助閱讀,不取代文字與數學定義。
作者: Neo.K
機構: EveMissLab/一言諾科技有限公司
日期: 2026-11-05
版本: v1.0
摘要
前篇 RGC–DPIED-01 至 03 已分別建立跨觀察者補正的可實現性、異質來源的學習衝突,以及多觀察者局部圖冊的任務充分性與動態閉合性。然而,這些結果仍預設系統已經收到某種觀測,或已知哪些觀測需要合併。對於具有主動感測與具身作用能力的 AI,更前置的問題是:當既有觀察無法支持指定任務時,系統如何判斷是否值得補觀測、應取得哪個觀察條件或通道,以及何時必須停止並拒絕行動?
本文提出「觀察者條件化的主動補觀測」(Observer-Conditioned Active Reobservation, OCAR)框架,將 COA 局部圖冊與 OCVC 條件契約擴展為逐步選擇感測查詢的有限信念決策問題。理論上,對成本為零、世界狀態不受觀測改變、且觀測模型正確的同時點決策,額外資訊不會增加最優貝氏風險;但資訊增益的大小不保證等於任務價值。更重要的是,單一步驟中資訊價值為零的觀測,仍可能作為後續專門感測決策的必要條件。
本文構造一個完全可枚舉的八狀態世界:目標變量由隱藏的通道選擇位元 決定,兩個資料位元 由不同通道提供。單獨觀測 的即時任務價值為零;但先觀測 、再依結果取得 或 ,其期望總決策損失與觀測成本為 。與之比較,同模型下最佳固定觀測子集的成本為 ,純單步貪婪策略為 。若 觀測正確率下降,最適決策會改變,說明來源可靠性不是可省略的元資料。
本文另外構造兩項相互獨立的反例:完美取得與任務無關的隱變量時,世界互資訊可高於一個有噪聲、但能減少任務錯誤的通道;而同一個隱變量對即時任務沒有價值,卻對下一時刻狀態預測具有決定性價值。本文由此將「當前任務價值」「長期世界模型價值」「時間與感測造成的狀態變化」「來源不確定性」「物理作用授權」分開,提出研究性接口 OCVC-0.5 / COA-0.2。所有量化結果僅在明確設定的合成世界成立,不應解讀為真實 AI 系統已獲得同等優勢。
關鍵詞: 主動感知;關係幾何;觀察者條件;值資訊;部分可觀察;貝氏決策;非近視觀測規劃;互補感測;世界模型;時效性;具身智能;拒絕機制
Abstract
The preceding RGC–DPIED studies developed conditional cross-observer correction, source-conflict models, and multi-observer chart consistency. This paper asks the next question: which missing observation should an embodied system acquire, at what cost, and under which conditions should it abstain? We propose Observer-Conditioned Active Reobservation (OCAR), a finite-belief decision formulation extending the COA/OCVC research contracts. We distinguish myopic value of sample information, nonmyopic conditional sensing, mutual information about the whole world, task-specific Bayes risk, and the dynamical effects of sensing. An exact eight-state witness gives expected classification loss plus sensing cost of 0.13 under optimal adaptive acquisition, versus 0.21 for the best fixed sensor subset and 0.33 for a one-step myopic strategy. A separate witness shows that world mutual information can rank sensors oppositely to their decision value; another shows that a query irrelevant to immediate classification may be crucial for transition prediction. The work includes exact rational enumeration and 62 unit tests. Its evidence is confined to mathematical and synthetic models, not visual foundation-model training or physical robot validation.
0. 研究問題、先驗成果與邊界
0.1 已有成果不應重複宣稱為新發現
RGC P01–P12 研究載體、幾何投影、觀測歧義、跨觀察者配準與局部圖冊。生物視覺分支 RGC-BV01–BV06 提供跳蛛分層視網膜、扇貝反射式視覺、口足類偏振受器,以及主動線掃描與時間補償等具體啟發。其生物名稱與理想數學感測模型必須區分;本文不聲稱完整重現生物神經處理。
RGC–DPIED-01 v1.1 提出觀察補正的任務充分性與不可恢復資訊之區別;RGC–DPIED-02 給出異質來源、姿態與可靠性不足的有限反例;RGC–DPIED-03 以條件式多觀察者圖冊(Conditional Observer Atlas, COA)將幾何對齊、任務充分性、動態閉合與物理作用授權分層。
本文將其中的靜態資訊判準推進為動態決策程序。它不是重新發明主動感知、貝氏實驗設計、POMDP 或值資訊(value of information);本文的研究增量是讓它們直接受觀察者載體幾何、任務條件、時效性及接口證據約束。
0.2 研究問題
給定一個觀察者 的觀測歷史 、任務 、候選感測動作集合 和物理動作集合 ,系統應能回答:
- 現有資料對目標是否足夠?
- 哪個觀察條件或感測通道最可能減少實際任務損失?
- 一個沒有即時價值的觀測,是否可能使後續觀測有價值?
- 取得更多資訊的時間、能源、物理擾動與風險是否值得?
- 即使模型內已達最適決策,哪些證據仍不足以授權實機行動?
本研究的精確定理主要限定在有限空間、已知轉移和觀測核、零一損失及理想化成本。沒有已證明所有視覺載體共享的維度不變量。
1. 文獻定位:不是感測越多越好
1.1 資訊的「較多」與任務的「較好」不是一回事
Blackwell 的統計實驗比較表明,若一個訊號能透過後處理隨機化取得另一訊號,則在相同決策時點、無額外成本的條件下,前者至少同樣有用 [E1]。這不是說世界互資訊越大、任務風險就必定越小:不同資訊結構可互不支配,且價值須相對於決策損失界定。
Krause 與 Guestrin 研究非近視值資訊與感測選擇 [E2];Golovin 與 Krause 研究在指定自適應次模性等前提下的貪婪近似保證 [E3]。因此不應把任何非近視、成本敏感的決策樹都宣稱為新演算法;同時也不能對不符合那些前提的主動感測過程隨意套用貪婪最佳化保證。
1.2 既有具身研究已直接處理主動感知
ActLoc 將可選相機姿態的定位品質引入導航規劃,並考慮動作約束 [E4]。Shi 等人的 POMDP 架構同時處理控制對狀態演化與感知通道的影響 [E5]。Hu 等人的研究則以真實機器人實驗探討主動感知策略的學習 [E6]。
特別值得注意的是,2026 年 9 月的 When to Make a Decision 已提出以任務充分性判斷何時停止感知的概念性架構,其摘要明示部分實機實作尚屬計畫 [E7]。2026 年 10 月的另一篇預印本則研究對象與任務感知的主動觀察及導航安全 [E8]。這些先例表示「AI 決定何時觀察」本身已是活躍且具體的研究方向。
本文的區別在於:將此前 RGC 的觀察者條件、跨觀察者相容性與 DPIED 的動態閉合性納入一個能被拒絕的決策契約,並以精確有限模型檢查單步收益、序列互補、時效與缺失通道的不同邏輯。
2. 形式化:世界、觀察條件、信念與任務損失
2.1 世界與觀察者的聯合隱狀態
令物理世界狀態集合為 ,來源條件及未知校準參數集合為 、 ,把決策相關且未確知的整體狀態寫為:
觀察歷史 產生信念:
一個感測查詢 不只指定「攝影機」或「影片」這種資料來源;它還應包括感測方向、投影或分析器狀態、時間、校準版本、可用通道、預定操作及不確定的來源報告。
在不改變世界的靜態理想模型中,查詢由觀測核表示:
其讀值分布與貝氏更新為:
若觀測會移動物體、改變光照、消耗時間,或造成新的接觸狀態,必須改用第 9 節的聯合觀測—轉移核。把來源條件 錯誤地固定成已知常數,是跨觀察者補正中一種常見的模型化風險;本文將它保留在聯合信念內。
2.2 任務目標與即時最適風險
對具有損失函數 的指定任務 ,定義:
本研究計算實驗使用二元標籤、零一損失及兩個分類動作;故 為兩類後驗質量中較小者。對不同機器人、不同控制期限或不同任務,損失函數不能不經轉換便視為相同。
2.3 查詢成本與物理約束
令查詢成本 ,可代表決策損失同一尺度下的時間或能源懲罰;安全風險 應另作硬性限制而非任意與成本互換。真實系統可以同時有時間截止、動作可達性、接觸力、距離、負載等條件,不能由單一數字替代。
對這篇的有限模型,成本只是假設的無因次值,不是某種機器人的實測耗能或失敗機率。
3. 定理一:同時點、無擾動感測的任務價值
3.1 定義單次值資訊
對狀態不變、模型正確、決策發生在同一時點的查詢,定義取得讀值後的期望最適風險:
任務的單次樣本資訊價值(Expected Value of Sample Information, EVSI)定義為:
考慮查詢成本時,單步淨價值為:
定理 3.1|額外免費資訊的弱單調性
在上述假設下,對任意有限觀測核 ,皆有:
證明。 任取查詢前的最適動作 。即使取得讀值,系統仍可忽略該讀值,對所有 繼續選擇 。所以每個讀值條件下的最適條件風險,皆不大於在該條件下固定採取 的風險。將不等式依 加權相加,可得 。證畢。
等號條件。 在有限動作集合且最適值可達的條件下, 當且僅當存在一個查詢前最適動作,在每個正機率讀值後仍然最適。這包含「觀察真的沒有區分任務狀態」和「觀察有資訊,但不足以改變最佳動作」兩種情況,不能誤解成觀測不含任何資訊。
3.2 Blackwell 支配的正確適用範圍
若查詢 可由查詢 的讀值經一個與世界狀態無關的隨機化核 產生:
則在同先驗、同時點、同動作集合、無差別成本與無狀態擾動的條件下:
因取得 的決策者可自行隨機生成 的訊號後模仿任何 決策策略。但不同感測物理通道不一定滿足此可退化關係;Blackwell 序不是把任意載體視覺自動排出強弱的全域排名。
4. 反例一:世界互資訊較多,任務價值仍可能較小
設世界 ,其中 為獨立且均勻的二元位元;任務是預測 。比較兩個查詢:
- :完美讀取與當前任務無關的 ;
- :以 的機率正確讀取 ,以 的機率翻轉。
兩者都是合法的有限觀測核,但不是彼此的 Blackwell 可退化版本。它們對完整世界 的互資訊分別為:
其中 。
但任務的先驗最適零一錯誤率為 ;取得 後仍為 ,取得 後變為 。因此:
解釋。 若把「看見世界」定義成盡量增加所有隱變量的互資訊,系統可能偏好對當前任務沒有任何直接價值的感測;相反,一個資訊量較小但與任務直接相關的低解析度通道,反而能降低決策損失。這是完整世界互資訊與任務風險排序不同的有限反例,並不表示互資訊作為資訊量定義有錯。
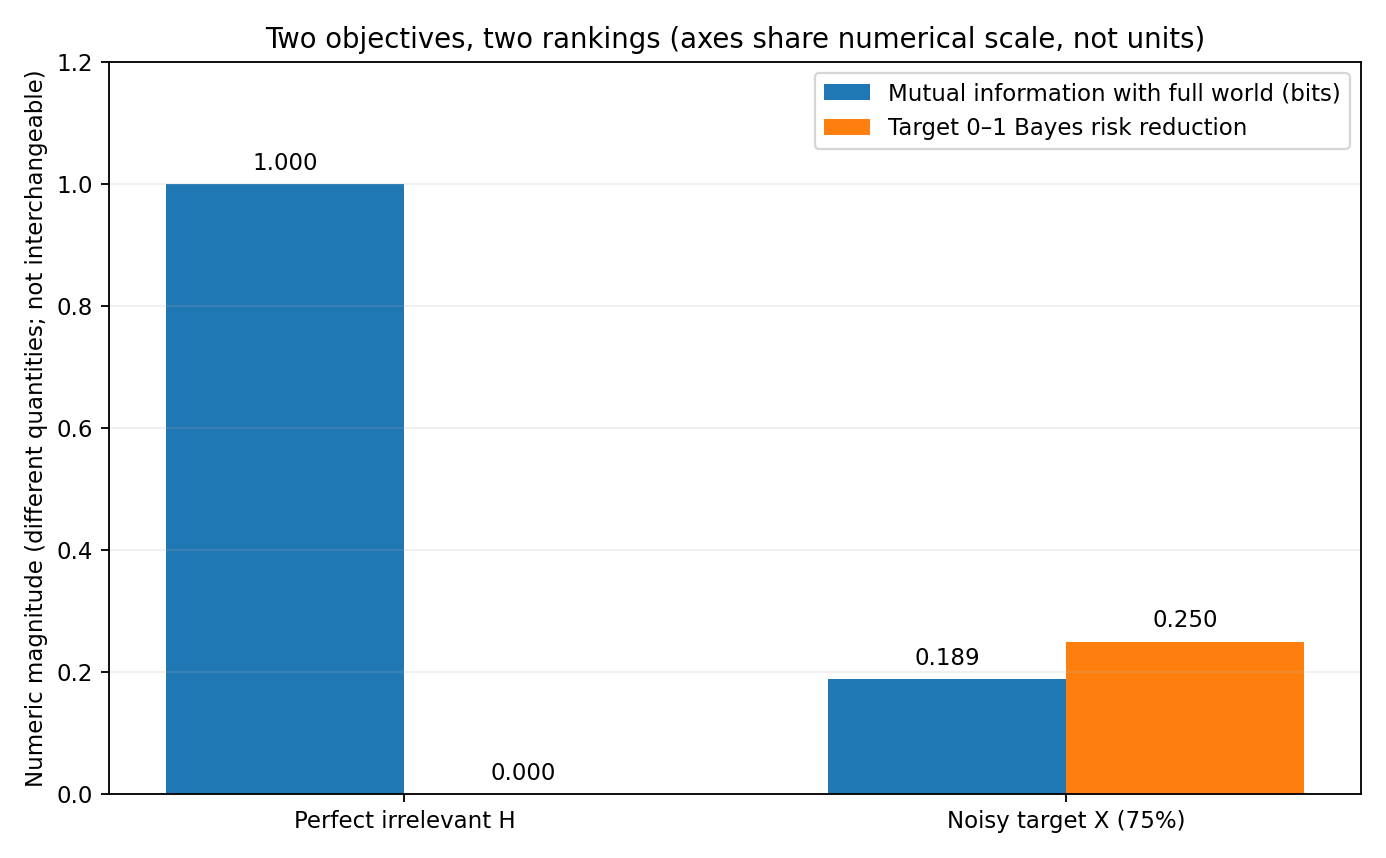
該圖以同一畫面並列數值,但兩個量的單位與意義不同;不能把高度直接當成同一個物理尺度。
5. 定理二:無即時價值的條件觀察,可以具有序列價值
5.1 八狀態「選擇哪個載體通道」模型
構造三個獨立均勻位元:
表示當前任務應使用哪個感測通道; 為兩個分別可被精確讀取的候選資料位元。任務標籤為:
允許三種不改變世界的查詢: ,每種最多使用一次,且理想情況下皆能精確回報對應位元。查詢成本為:
成本與零一任務損失使用同一假設尺度。
5.2 單次資訊無法看見先驗依賴
由對稱性, 與 獨立。即使已知 ,仍然不知道相應的 或 ,故:
於是 ,而其淨即時價值是 。單步貪婪選擇器會將它排除。
反之,知道 但不知道 時,在 的一半情況下答案正確決定;在另一半情況下,未知 仍然均勻。因此:
且 對稱。兩者的單步淨價值皆為 。
定理 5.1|指定八狀態模型的非近視策略優勢
在上述精確、靜態、有限成本模型下:
- 最適自適應策略:先查詢 ,再依結果查詢 或 ,期望總損失加查詢成本為 ;
- 最佳固定查詢子集:一次預先承諾查詢 ,其期望總成本為 ;
- 純單步貪婪策略:先查詢 或 ,得到最終任務風險 、查詢成本 ,合計 。
證明與可查驗性。 對第一項,查詢 花費 ,其結果直接決定下一個應讀取的資料位元;第二步花費 並唯一確定 ,故合計 ,最終任務風險為零。
對固定查詢子集,列舉 的所有八個子集。只有三個全查詢才能對每一個可能世界零錯誤地判定 ;其成本 。其他子集的風險加成本不小於 ;完整結果列於第 12 節。故 是所有固定子集的最小期望總值。
對第三項,初始單步淨價值 、 。選擇其中一個資料位元後,剩餘任一個單次查詢在當下都不能再降低最適零一風險:只知道另一個資料位元而不知 ,或只知道 而缺少相應位元時,其期望殘餘風險仍為 。因此純單步貪婪停止,合計 。為確認不只此三種候選策略,將「第一步停止、先查 、先查 、先查 」四種情況逐一套用第 6 節有限 Bellman 遞迴,所得總值分別為 。因此即使容許每次依讀值改變後續順序,仍以 為全體允許策略的最小值。證畢。
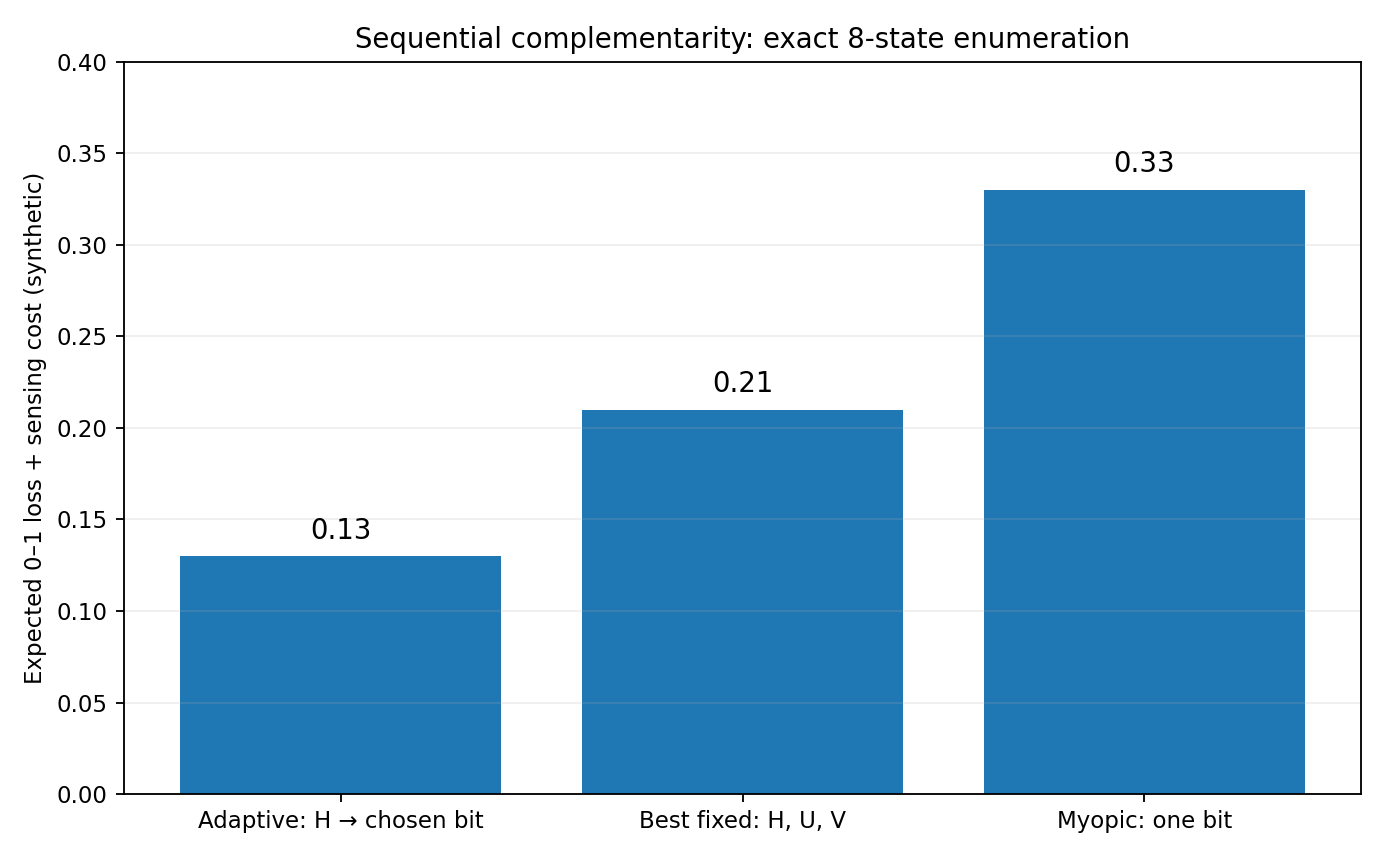
核心意義: 在第一步並未減少任務分類錯誤,卻使第二步能選擇正確的感測載體。在機器人系統中, 可類比為「此區域適合哪一類感測器」「哪個觀察幾何仍有效」或「目前哪套校準適用」等條件;本模型並未聲稱這些現實條件一定是單一二元位元。
5.3 不是普遍優勢或通用新定理
該 優勢依賴特定查詢成本、資料分布、模型完全已知及世界在兩次查詢間保持不變。若查詢 過慢、過於昂貴、讀值不可靠或本身會擾動環境,最佳策略可能改變。若任務只需要 ,則額外觀測 根本沒有價值。本文沒有證明 OCAR 對任意資料集優於現有方法。
6. Bellman 形式化:知道何時查、何時停
令 是尚未用過的查詢集合, 是可用信念,且所有查詢不改變世界、不耗費外部狀態時間。定義最小的「後續觀測成本+最終任務風險」為:
第一項是現在停止;第二項是執行查詢並根據結果重新規劃。當 為空集合時, 。
命題 6.1|有限、無重複查詢條件下的 Bellman 最適性
在已知有限觀測核、損失與成本,且每種查詢最多使用一次的模型中,上述遞迴給出允許依每次讀值選擇後續查詢、並可隨時停止的最小期望總損失。
證明。 以尚未使用的查詢數量做歸納。當 為空,沒有查詢可選,最適值只能是立即停止的 。若命題對所有少於 個可用查詢的問題成立,當前有 個查詢時,任何策略的第一步不是停止,就是選一個 ;後者觀測後的剩餘問題只有 種查詢,依歸納假設其最適成本為 。對結果取期望並在所有第一步之間取最小,即得遞迴式。證畢。
本定理是有限信念決策樹的標準動態規劃推理,不是宣稱所有 POMDP 均能以同樣成本精確求解。狀態、歷史、查詢與連續控制空間擴大後,計算可能迅速不可行,需使用近似或特定結構;本文沒有證明任何新近似方法的誤差上界。
6.2 停止不是失敗,而是一個正式動作
若所有允許的查詢相對於現在停止,都無法降低總期望損失,理想模型會選擇停止;但停止後仍須區分「可以安全執行指定任務」與「必須拒絕實機行動」。當最小分類損失仍很高時,「不再感測」不是「有足夠信心動作」的同義詞。
7. 來源標記可靠性如何改變最適補觀測
把 的讀取從完美觀測改為二元對稱混淆通道,報告正確率為 ,且 ;讀取 仍為完美。令系統正確知道通道可靠度 。
考慮一個指定的兩步策略:先查詢帶噪聲的 ,再根據回報值查詢對應的 或 。若 回報錯誤,系統可能讀取與任務無關的資料位元;在這種情況下,兩位元相異機率為 ,所以該策略最終分類錯誤率為:
因此這一指定候選策略的總值為:
與只讀取 的 相比,此候選策略在 時更有利;在 相等。這是對兩種候選策略的精確比較,不應無條件擴展到所有可能策略族。
已用第 6 節的 Bellman 枚舉,在下列具體可靠度得到最適結果:
| 正確率 | Bellman 最適期望總值 | 最適首查詢 | 純單步貪婪總值 |
|---|---|---|---|
| (或對稱的 ) |
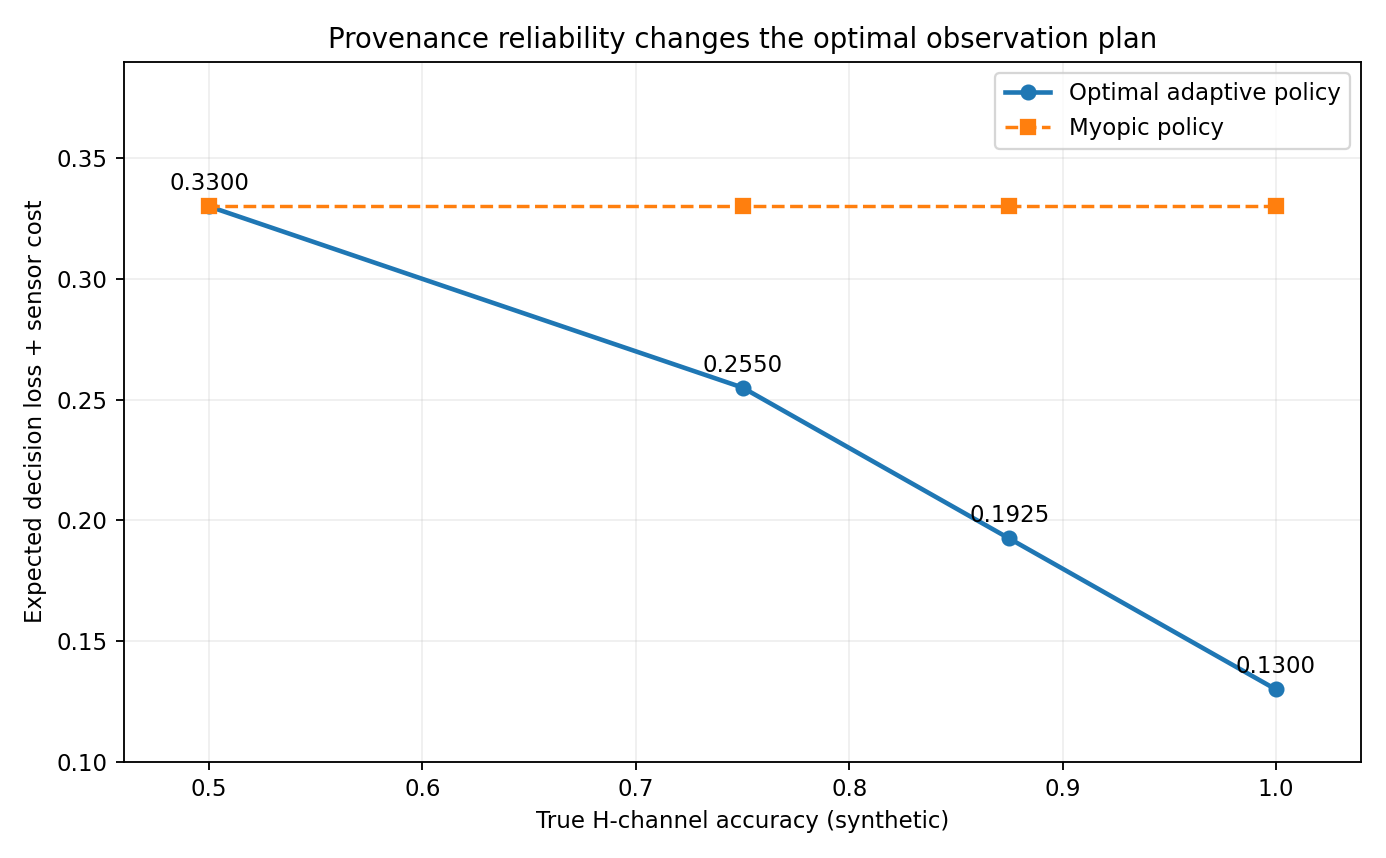
當 , 的讀值與真實條件獨立,花費 取得它無助於合理選擇下一感測器。這說明來源、校準與觀察條件的可靠性直接影響最適查詢策略。
本研究另外以 的 51 個有理數網格點執行精確 Bellman 枚舉,與兩候選策略取小者一致;該網格驗證不能取代整個連續區間的解析證明。程式及測試範圍清楚列於第 12 節與附錄。
8. 即時任務與動態模型所需要的資訊不同
8.1 兩位元動態狀態的最小反例
令世界狀態為 ,且目前已知 ,但 均勻未知。指定下一步演化:
若當前任務只是預測 ,已經完全可知,因此查詢 的即時零一任務價值為零。
若世界模型任務改成預測 ,在未知 時,最佳預測錯誤率為 ;查詢 後降為零:
所以「視覺資訊不足」必須帶上任務、動作和預測時域。對當前辨識足夠的觀察,可能對後續動態不夠;反過來,為了長程運動模型而關鍵的隱變量,未必對即時影像分類有任何價值。
8.2 接回 RGC–DPIED-03 的動態閉合條件
前篇要求抽象世界狀態在給定動作下具有可定義的後繼。若兩個真實狀態產生相同抽象狀態,卻對指定動作導致不同抽象後繼,就不能把該抽象當成充分的動態狀態。
本文的主動補觀測器可以據此設定查詢目標:不僅是取得立即標籤 ,而是取得被宣告為必要的下一狀態量,例如 ;對隨機演化則需考慮後繼分布。這是任務條件化,而不是把世界模型自動當成越高維越好。
9. 時間、接觸與感測擾動:額外資訊並非免費
9.1 正確的聯合觀測—轉移核
若查詢 會使世界變化,應使用:
而非只使用 並默認查詢前後 。其狀態及參數後驗為:
若觀察者本身位置、接觸狀態或校準條件會轉移,也應把它們納入擴展的隱狀態;上式僅展示最簡單的狀態—參數情形。注意分母按實際讀值 加總,不可把未觀測的情形誤混。
9.2 一個嚴格限定的時效反例
令當下二元目標為 ,先驗較可能為 ,其中 。若現在直接分類,錯誤率為 。
若先用完美感測器讀取 ,但此過程使動作延後一步,而目標每一步獨立以 的機率翻轉,則使用剛才讀取的 預測 的錯誤率為 。因此:
這不是反駁定理 3.1,因為兩個策略採取動作的時間與被評估的真實狀態並不相同。若比較的是相同的 時點,卻不作任何感測,則最佳風險為:
故同時點比較時,完美的舊時刻觀測仍把風險由 降至 。觀測可能因延遲而不值得做,但不能偷換時點後宣稱免費資訊在相同決策問題中增加了 Bayes 風險。
9.3 主動觸碰可能改變被觀測對象
如果機器人透過接觸判斷重量分布、摩擦或穩定性,接觸本身可能改變物體姿態與支持關係。若「完美讀取接觸前位元」之後,物理過程完全重新隨機化該位元,則舊讀值對接觸後位元的分類風險依然是 。這並不是編碼器不足,而是當前觀測與需要控制的後繼狀態並不具備識別關係。
因此,介面必須區分 READ_ONLY_IN_MODEL、WORLD_ALTERING_QUERY、UNKNOWN_TRANSITION,並讓不能建模的作用依約拒絕,而不是假定一切感測等同無成本地索取資料。
10. 感測盲區與跨載體不可替代性
10.1 觀察條件再怎麼旋轉,也不能憑空生成缺失物理通道
取世界 為兩個獨立均勻位元;所有可用的同一類觀測查詢都只回報 ,而任務目標是 。無論重複查詢 幾次、用多少個同類觀察者重新編碼 ,都不能將 的最適錯誤率從 降低。在本模型中,增加一個能精確讀取 的不同感測通道,才會使任務錯誤率變成零。
形式化理由。 在既定先驗下,任何由 單獨產生的觀測歷史 都與 獨立,所以 。故任意依 產生的二元分類器,期望零一錯誤率至少為 。
這與 RGC-BV04 的理想 Stokes 偏振分析相呼應:改變線偏振分析器方向可以增強對相關線偏振量的可辨識性,但若始終缺少對圓偏振分量的量測敏感度,僅靠同類量測旋轉仍無法恢復該分量。此處的位元是抽象反例,不能將其數值對應到口足類真實視覺精度。
10.2 多觀察者「互補」不等於「可相互轉譯」
兩個局部圖冊即使沒有共同的可逆坐標,也可能共同提供完成任務所需的互補變量。例如一個深度感測器測得接近幾何,另一個觸覺感測器提供接觸後阻力。要求兩者強制轉換成相同 RGB 張量不會使它們物理等價;合理的做法是保留來源、觀察條件和物理量單位,在任務限定的共同信念中融合。
11. 從值資訊到「何時停止、何時拒絕」的雙重閘門
11.1 查詢決策與物理授權是不同輸出
本文建議將模型內查詢決策與實機執行授權分為兩個獨立程序:
- 模型內決策: 現在停止是否比任何合格查詢的預期總代價更低?若未停止,最值得取得哪一種觀察?
- 作用安全: 該觀測動作是否具有合格時效模型、校準、物理可達性、碰撞與接觸風險評估,以及其他部署環境要求?
例如在純合成模型中,某接觸查詢的假設不安全事件機率為 ,而合同門檻為 ,即使資訊價值很高仍應拒絕。相對地,一個假設風險 的攝影機查詢只能通過該模型內的風險門檻,不能據此宣稱實機已安全。
11.2 模型內的停止/拒絕狀態
推薦的研究性狀態包括:
| 狀態 | 意義 | 允許推論 |
|---|---|---|
REQUEST_CONDITION_MEASUREMENT |
需要先辨識哪個視覺/感測條件有效 | 可以探索後續查詢,不代表已能執行任務 |
REQUEST_COMPLEMENTARY_CHANNEL |
既有載體缺少任務所需物理量 | 要求不同通道,不得假造缺失訊號 |
STOP_SENSING_MODEL_OPTIMAL |
在限定信念/成本/查詢集合內,繼續感測沒有較低期望成本 | 僅代表模型內最適停止 |
REJECT_TIME_OR_CALIBRATION |
來源、標定或時間條件不足 | 不能套用該補正與決策證據 |
REJECT_UNSAFE_QUERY |
模型內已超出明定風險門檻 | 不得執行該查詢 |
MODEL_ONLY_QUERY_ELIGIBLE |
限定模型通過必要欄位檢查 | 不代表授權真實致動 |
REAL_ACTION_NOT_AUTHORIZED |
尚未完成物理執行與安全證明 | 不得轉換為實機控制命令 |
可靠的具身 AI 不應把「模型內不再值得觀測」自動解讀成「物理上可以立即操作」。這是 DPIED 關於數位能力和實際作用之間必須保留的分界。
12. 已執行的精確有限模型實驗
12.1 算法與可重製性
研究包 src/active_observation.py 使用 Python 標準庫的 fractions.Fraction 對信念更新、風險、查詢成本、決策樹與固定子集做精確有理數計算。非整數資訊量以浮點數表示,並以 解析公式獨立比對;沒有把 IEEE 浮點輸出冒充有理數精確值。
tests/test_active_observation.py 具有 64 項可執行單元測試;其中一項對八狀態全部 個非空先驗支集的均勻支集分布逐一測試三種查詢的免費資訊單調性。因此本檢查恰有 255 種非空先驗支集;未包含空支集。另以可靠度網格 至 每次增加 進行 51 次有限策略窮舉。
12.2 八狀態策略的完整最適值比較
| 策略 | 最終分類錯誤風險 | 期望觀測成本 | 兩者合計 |
|---|---|---|---|
| 自適應先查 ,再選 或 | |||
| 最佳固定查詢 | |||
| 純單步貪婪,只查 或 | |||
| 完全不觀測 |
以上是同一有限機率模型下的期望風險和成本,不是多模態模型的準確率、實測機器人的成功率或實際耗能。
12.3 全八種固定查詢子集
| 固定查詢集合 | 最終錯誤風險 | 成本 | 總值 |
|---|---|---|---|
12.4 輔助有限模型的精確結果
| 檢查項目 | 結果 | 僅能支持的結論 |
|---|---|---|
| 完美讀取無關位元 | 世界互資訊 bit,任務值 | 資訊量與任務收益不等價 |
| 正確率讀取目標 | 世界互資訊約 bit,任務值 | 弱訊號仍可改變任務決策 |
| 已知 、未知 ,下一狀態 | 查詢 對當前 價值 ,對下一步預測價值 | 必須指定預測時域 |
| 舊時間完美觀測,之後 機率翻轉 | 感測後延遲動作風險 ,直接即時動作風險 | 不同作用時間不可偷換 |
| 同一延遲時點完全不感測 | 風險 | 同決策時點免費資訊仍有價值 |
| 只可觀測 ,任務要求獨立 | 錯誤率永遠 | 未量測物理通道不能靠重編碼恢復 |
| 新增完美 通道 | 錯誤率 | 互補感測可能必要 |
| 合成接觸觀測風險 ,門檻 | REJECT_UNSAFE_QUERY |
僅展示研究性硬閘門 |
12.5 驗證狀態與重現命令
python -m unittest discover -s tests -v
PYTHONPATH=src python src/active_observation.py > results/exact_results.json
PYTHONPATH=src python src/render_figures.py
python validate_release.py
第二、三行為 POSIX shell 寫法;Windows PowerShell 可先執行 $env:PYTHONPATH='src' 再執行兩支 Python 程式。本研究無須 GPU、LLM API、ROS 2 或其他重量級 Python 套件即可執行核心計算;繪製 PNG/SVG 需要 matplotlib。
13. 候選工程接口:OCVC-0.5 / COA-0.2 / OCAR-0.1
13.1 從已有的圖冊與補正契約擴展
前篇提出 OCVC-0.4 / COA-0.1,以來源、同步、重疊幾何、任務充分性、動態閉合和物理作用授權檢查為核心。本文提出研究性補丁 OCVC-0.5 / COA-0.2 / OCAR-0.1,新增:
query_space:目前允許的候選感測查詢,及每個查詢的物理通道、姿態與可達性條件;query_cost_and_deadline:觀察成本、最大時間、過期條件與任務時域;belief_provenance:信念版本、來源身份、標定不確定性與可信度來源;state_changing_query:感測是否改變世界、是否有經驗證的聯合觀測—轉移核;task_value:相對於指定任務損失而非僅對全部世界熵的邊際價值;plan_horizon:一個或多個補觀測步驟,以及是否允許依新讀值調整後續查詢;abstention_contract:何時停止、拒絕感測、要求新通道、拒絕物理執行。
隨包 schemas/ocvc05_coa02_active_query_example.json 是研究範例,不是 ROS 規範、正式 JSON Schema 或任何產業實際協定。欄位是否存在、版本是否已驗證與實體憑證是否可信,在目前程式中都只以有限規則示範。
13.2 最小執行邏輯
propose_active_observation(belief, source_contracts, task, horizon):
    validate_source_identity_condition_and_time()
    determine_task_information_and_declared_dynamic_state()
    available_queries = reject_missing_or_unsafe_query_models()
    if no_valid_joint_observation_transition_model():
        return REJECT_INCOMPLETE_MODEL
    plan = minimize_expected_task_loss_plus_query_cost(
        belief, available_queries, horizon, include_STOP=True
    )
    if plan.requires_missing_physical_channel:
        return REQUEST_COMPLEMENTARY_CHANNEL
    if plan.choice == STOP:
        return STOP_SENSING_MODEL_OPTIMAL
    return MODEL_ONLY_QUERY_ELIGIBLE

# Physical execution authorization is a separate mechanism.
MODEL_ONLY_QUERY_ELIGIBLE 不得自動發送致動命令。要接入真實機器人,仍須驗證每個感測動作的安全域、時延、定位、硬體狀態、通訊狀態與作用模型。
14. 生物視覺、關係幾何與世界模型的整合
14.1 不同生物視覺,提供不同的可檢驗觀測選擇
對跳蛛視覺而言,分層視網膜、運動眼睛與多通道資訊可以作為「選擇哪個視角或焦點」的研究靈感,但不能把有限模型的 直接當作跳蛛實際神經閘門。對扇貝類視覺而言,反射光學與多受器結構提示「不同感測路徑可以保留不同關係」,但不應推斷扇貝具有人類式三維模型。
對 BV04 的口足類偏振模型,補觀測器應辨識「調整分析器方向」與「新增真正可量測的物理通道」是兩類不同查詢;對 BV05–BV06 的一維主動掃描,查詢的順序、移動代價與場景運動則成為不可忽略的狀態。這與本文非近視決策及動態修正直接對接。
14.2 視覺維度不變量仍是開放假設
即使存在某些跨觀察者的不變量,也不代表所有觀察者都可以復原同一個完整世界、共享同一感測坐標或實現同一組物理動作。實務上更弱且較容易驗證的要求是:對指定來源、條件、任務、動作與時間,保留必要的不變關係、可轉換的等變關係以及不可辨識的不確定性。
因此,OCAR 不把「強制統一視覺維度」設為先決條件,而將「能否合法補觀測」視為一個受限任務決策問題。
14.3 與 DPIED 的具身限制重新連接
AI 可能具有優秀的數位推理能力,仍然缺少可觀測、可觸及、可控制或可安全驗證的物理條件。OCAR 能夠在數位層標記「必要資料缺口」與「建議下一個感測操作」,卻不提供真實世界的致動能力、傳感硬體或安全承諾。因此從觀測建議到物理行動的最後一段,仍須獨立驗證與授權;不能用數學合理性代替現場責任。
15. 可反駁工程檢驗與嚴格限制
15.1 檢驗假設
本篇工程假設可寫為:在來源條件可追溯、觀測時效與感測成本明確、且部分感測資訊具有序列互補的任務上,條件式多步查詢規劃可能相較於忽略來源條件的單步貪婪選擇器,在相同任務與資源限制下減少期望決策損失。這不是已證實的泛化結論。
一個公允的比較應至少涵蓋:隨機查詢、固定查詢順序、資訊熵貪婪、任務風險單步貪婪、完整條件式多步策略、刪除來源元資料策略、加入錯誤標定的策略。所有方法必須用同一組任務、相同成本計量、等價控制期限與相同的實體安全約束評估。
15.2 必須分別測量的指標
應分別紀錄任務完成品質、世界模型一步與多步預測誤差、實際量測代價、重新校準頻率、來源錯標率、過期觀測比率、碰撞與接觸風險、拒絕率、在未見過載體與未見過視角下的效能,以及實機和模擬環境間的差距。不可以只用單一影像辨識準確率聲稱全部跨具身能力進步。
15.3 可推翻本篇工程主張的情況
在控制來源、模型容量與算力等因素後,如果多步條件式規劃沒有降低總任務損失,或改進全部來自較多感測預算、更多的監督標籤或優先取得完整場景真值,則不能把改善歸因於觀察者條件化接口。若補正機制導致安全風險上升,即使數位測試分數增加,也不能算為有效的具身成果。
此外,多步規劃面臨模型錯配、信念退化、計算成本、未建模非平穩性與安全閘門過度保守等問題。本文的 64 項通過測試只在限定程式與有限世界中驗證公式和邏輯,不等於獨立形式驗證器、同行審查或真實系統可靠性證書。
16. 結論
本篇把跨觀察者視覺補正研究推進到主動資訊取得的決策層。它建立了四項彼此不能替代的區分:第一,世界資訊量不等於任務資訊價值;第二,單步零價值不等於多步零價值;第三,即時任務充分不等於動態世界模型充分;第四,模型內值得觀察不等於物理上允許觀察或行動。
在精確八狀態模型中,觀察者先讀取一個當下不提供標籤資訊的通道選擇條件,再讀取正確的專門感測器,可達到 的最小總值,優於最佳固定查詢子集 與單步貪婪 。這不是一項關於真實 AI 性能的普遍宣稱,而是清楚可複製的數學見證:資料缺口的辨識、觀察條件的選擇,以及下一步感測的因果順序,可能比單純增加資料數量更重要。
對 RGC 而言,觀察者不是只被動接受幾何影像的座標系;它也可以透過主動選擇觀測,改變可辨識的關係。對 DPIED 而言,真正可作用的世界模型必須在每一步知道自己根據何種觀察、具有多大限制,以及哪些物理動作尚不能授權。
一個能看見更多的系統,不必然更理解世界;而一個知道應該如何觀察、何時停止與何時不該行動的系統,才可能讓觀察真正轉化為可靠的作用。
參考文獻
外部可核對來源
- [E1] Blackwell, D. (1953). Equivalent Comparisons of Experiments. The Annals of Mathematical Statistics, 24(2), 265–272. DOI: https://doi.org/10.1214/aoms/1177729032
- [E2] Krause, A., & Guestrin, C. (2005). Near-Optimal Nonmyopic Value of Information in Graphical Models. UAI 2005, 324–331. https://mlanthology.org/uai/2005/krause2005uai-near/
- [E3] Golovin, D., & Krause, A. (2011). Adaptive Submodularity: Theory and Applications in Active Learning and Stochastic Optimization. Journal of Artificial Intelligence Research, 42, 427–486. https://doi.org/10.1613/JAIR.3278
- [E4] Li, J., Sun, B., Di Giammarino, L., Blum, H., & Pollefeys, M. (2025). ActLoc: Learning to Localize on the Move via Active Viewpoint Selection. CoRL 2025, PMLR 305, 1225–1245. https://proceedings.mlr.press/v305/li25b.html
- [E5] Shi, C., Dorothy, M. R., & Fu, J. (2025). Integrated Control and Active Perception in POMDPs for Temporal Logic Tasks and Information Acquisition. arXiv:2504.13288. https://arxiv.org/abs/2504.13288
- [E6] Hu, E. S., et al. (2025). Real-World Reinforcement Learning of Active Perception Behaviors. arXiv:2512.01188. https://arxiv.org/abs/2512.01188
- [E7] da Silva Barros, M., Kerzel, M., Weber, C., & Wermter, S. (2026). When to Make a Decision: Task-Sufficient Active Perception for Mobile Manipulator Robots. arXiv:2610.23891. https://arxiv.org/abs/2610.23891
- [E8] Qian, J., et al. (2026). Object- and Task-Aware Active Perception for Safe Navigation of Mobile Manipulators in Semi-Static Environments. arXiv:2610.29964. https://arxiv.org/abs/2610.29964
上述預印本若有新版,其研究結論與部署證據可能更新;本稿僅在 2026-11-05 的可查閱資料範圍內引用。
內部研究依據
- [P1] RGC P01–P12:關係幾何、載體展開、投影逆問題、跨觀察者圖冊及全域配準,來自使用者提供的《關係幾何與載體展開:三線成方問題》研究封存。
- [P2] RGC-BV01–BV06:生物視覺、主動掃描、偏振通道與場景運動補正;BV04 來自單獨補交的
BV04_Research(1).zip。 - [P3] DPIED-04–07:從影片到具身作用、跨時間運行、虛實遷移及長程可靠性;來自使用者提供的《數位—實體智能演化解耦論》研究封存。
- [P4] RGC–DPIED-01 v1.1:跨觀察者視覺補正的可實現性。
- [P5] RGC–DPIED-02:異質視覺資料的條件衝突與補正可靠性。
- [P6] RGC–DPIED-03:多觀察者視覺的條件式圖冊、共同表示與世界模型一致性。
附錄 A|定理、演算法與證據類別對照表
| 主張 | 精確假設 | 本稿提供的證據 | 未證明的擴展 |
|---|---|---|---|
| 額外免費資訊不增加 Bayes 風險 | 相同時點、相同目標、狀態不變、正確觀測核 | 決策可忽略訊號的證明、有限先驗枚舉 | 含時延與世界擾動的一般機器人 |
| 完整世界互資訊與任務價值不等價 | 兩獨立均勻位元、指定噪聲觀測 | 精確任務風險、解析資訊量 | 所有特徵學習模型 |
| 非近視條件觀察可能優於單步貪婪 | 八態、指定成本、靜態、查詢最多一次 | 完整子集枚舉、Bellman 決策樹 | 任意感測成本與連續狀態 |
| 通道來源錯標改變策略 | 二元對稱噪聲且其正確率被正確建模 | 四項精確成本、51 點掃描 | 未知非平穩校準 |
| 當前任務與下一狀態有不同資訊需要 | 、已知 | 二元條件分析 | 任意多步動態預測 |
| 過期量測不能當前時刻真值 | 指定翻轉機率、明示不同決策時點 | 有理數算例及同時點對照 | 一般連續運動與接觸動力學 |
| 缺失物理通道不能從同類觀察恢復 | 獨立位元與只讀 的觀測 | 獨立性與 Bayes 下界 | 一切生物視覺都具有獨立位元結構 |
| 安全閘門拒絕高風險查詢 | 指定合成風險與門檻 | 程式規則與測試 | 物理碰撞安全認證 |
附錄 B|可重製研究包內容
RGC_DPIED_04_2026-11-05/
  RGC_DPIED_04_Observer_Conditioned_Active_Reobservation.md
  README.md
  SOURCE_TRACEABILITY.md
  schemas/
    ocvc05_coa02_active_query_example.json
  src/
    active_observation.py
    render_figures.py
    evaluate_grid.py
  tests/
    test_active_observation.py
  figures/
    01_adaptive_vs_fixed_vs_myopic.png
    01_adaptive_vs_fixed_vs_myopic.svg
    02_calibration_reliability.png
    02_calibration_reliability.svg
    03_world_information_vs_task_value.png
    03_world_information_vs_task_value.svg
  results/
    exact_results.json
    reliability_grid.json
    unit_tests.txt
    validation_report.json
  validate_release.py
  SHA256SUMS.txt
本研究包僅納入本篇的程式碼與圖表,不重新打包前篇大型研究壓縮檔。舊成果請以原始版本與其獨立測試報告為準。